Ihre Transaktionsdaten enthalten bereits das nächste Design-in. Die Herausforderung besteht darin, es dort herauszuholen.
Warum das entscheidende Wissen in einer Vertriebsorganisation nicht allein im Produktkatalog liegt, sondern in den Beziehungen darin – und was nötig ist, um die relevanten Querverbindungen aufzudecken.
6
Min
Antonello Terlizzi
Predictive Analytics
Sales Intelligence
Data Science
Die Portfolios, mit denen Vertriebsteams in der Elektronikbranche arbeiten, sind riesig und komplex – zehntausende oder hunderte Tausende bestellbarer Bauteile sind für einen Design-in Distributor oder Hersteller keine Seltenheit. Die offensichtliche Schlussfolgerung lässt nicht lange auf sich warten: Kein Sales Engineer, wie erfahren auch immer, kann einen Katalog dieser Größenordnung im Kopf behalten.
Das war jedoch nie das eigentliche Problem. Bauteile generieren Umsatz – aber selten einzeln. Ein Design erfordert mehr als nur die eine Komponente, nach der der Kunde zufällig gefragt hat. Und die Sockets, die Sie nicht besetzen, bleiben nicht leer; ein Mitbewerber besetzt sie. Der Umsatz, der ein erfolgreiches Design von einem mittelmäßigen Projekterfolg unterscheidet, liegt also in den Beziehungen zwischen den Bauteilen: Welche Komponente wird typischerweise zusammen mit welcher anderen verwendet, in welcher Art von Applikation und in welchem Kundenhintergrund? Diese Beziehungen sind das eigentliche Asset, und sie vervielfachen sich deutlich schneller als der Katalog selbst. Sie fehlen nicht – sie sind vergraben. Jede einzelne steckt bereits in den eigenen Unternehmensdaten, verteilt auf tausende abgeschlossener erfolgreicher Transaktionen, Design Registrations und Projekten. Doch nichts davon ist etwas wert, solange es nicht extrahiert und jemandem vorgelegt wird, der danach handeln kann. Genau diese Datenanalyse findet heute in den meisten Fällen nicht systematisch statt. Wer im CRM oder ERP Opportunität für Opportunität durchgeht, betrachtet stets nur den Einzelfall – während das Muster erst im Aggregat sichtbar wird. Und genau dieses Aggregat kann eine solche Einzelansicht nicht zeigen.
Nutzen, was die Systeme bereits enthalten
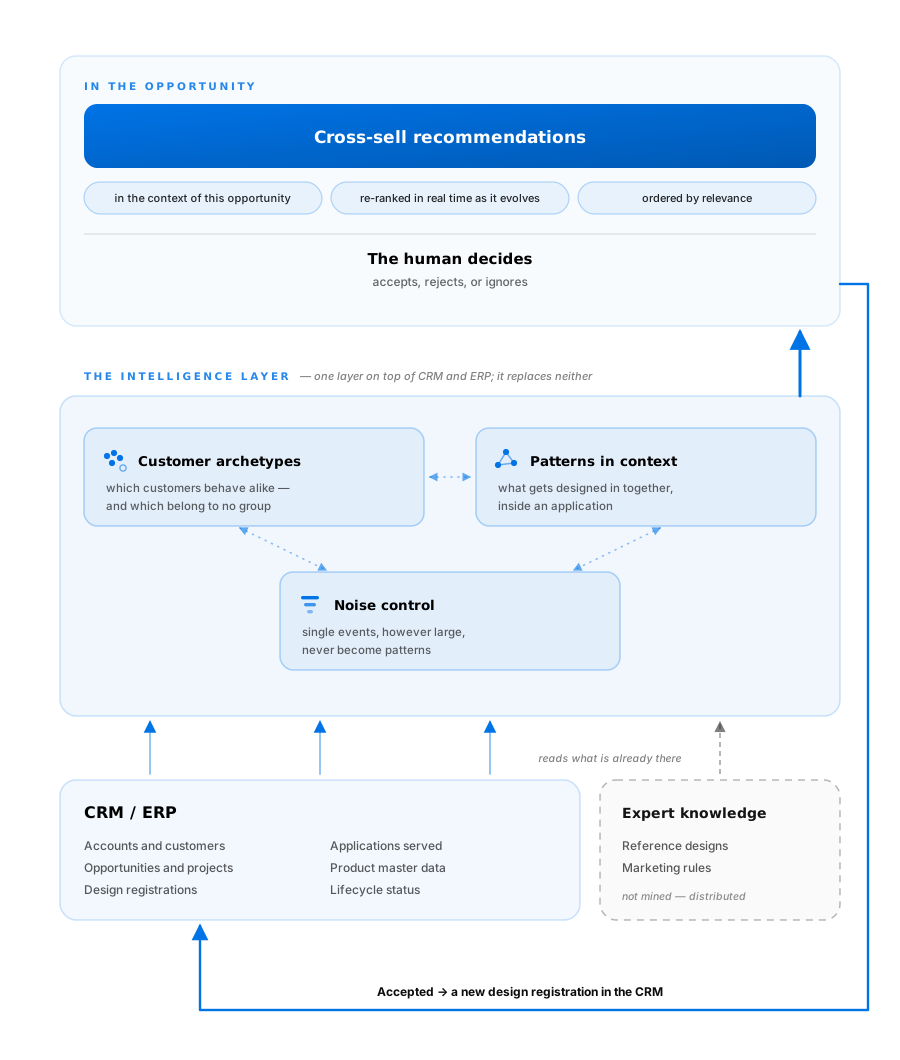
Diese zusammengefassten Muster nutzbar zu machen, ist keine Reporting-Aufgabe. Der Prozess muss kontinuierlich über den gesamten Datenbestand laufen und seine Erkenntnisse dem Vertrieb genau im richtigen Moment der Arbeit bereitstellen – dies ist exakt die Aufgabe einer Recommendation Engine. Eine speziell für diesen Anwendungsfall in der Elektronikindustrie entwickelte Recommendation Engine beginnt daher nicht mit neuen Daten, sondern mit den bereits vorhandenen Datensätzen. Sie ersetzt weder CRM noch ERP; sie setzt als Layer darauf auf und liest aus, was dort bereits vorhanden ist: Welche Kunden haben welche Bauteile gekauft, in welchen Projekten, für welche Applikationen und mit welchem Ergebnis? Es muss nichts Neues erhoben werden: Der Transactional Record, den Vertriebsteams seit Jahren pflegen – oft mit einer gewissen Enttäuschung darüber, wie wenig Nutzen sie dafür zurückerhalten –, enthält bereits alles darüber, was eindesigned wurde und was daraus geworden ist. Diese Historie erweist sich als das eigentliche wertvolle Rohmaterial.
Was diese Daten liefern, sind Muster: Kombinationen, die in erfolgreichen Designs immer wieder auftauchen. Und da die Engine als Intelligenz-Schicht und nicht als statischer Bericht fungiert, kann sie neben den vergrabenen Insights ein zweites Expertenwissen einbinden. Reference Designs enthalten bereits gezielte Engineering-Entscheidungen darüber, welche Komponenten zusammengehören. Das Produktmarketing weiß wiederum, welche Cross-Sell-Opportunitäten strategisches Gewicht haben – eine Einschätzung, die besonders bei Produkteinführungen (NPI - New Product Introductions) zählt, wo noch keine Transaktionshistorie vorliegt. Heute erreicht dieses Wissen meist nur wenige Personen in einer Schulung und verpufft danach häufig. Über denselben Layer ausgespielt, erreicht es jeden Sales Engineer – genau in dem Kontext, in dem es gebraucht wird: direkt an eine reale Opportunität angehängt, statt in einem Ordner zu liegen.
„Was verkauft sich zusammen?“ ist die falsche Frage
All das ist wertlos, wenn die an die Daten gestellte Frage zu generisch ist. Die naheliegende Frage – welche Produkte sich zusammen verkaufen – mittelt das Verhalten über eine Kundenbasis, die keineswegs einheitlich agiert, und liefert Empfehlungen, die zwar technisch korrekt, aber kommerziell weniger aussagefähig sind.
Die Frage muss mehr Kontext tragen: Nicht nur, welche Produkte zusammen auftreten, sondern in welcher Applikation und in welchem Kundenkontext. Eine Kombination, die bei Industrial Drives stark ist, kann in Automotive Body Electronics völlig irrelevant sein. Und ein Muster, das bei Tier-1-OEMs mit eigenen Design-Kapazitäten gilt, trifft möglicherweise nicht auf kleinere Design Houses zu, die stark auf Distributionssupport angewiesen sind. Kunden danach zu gruppieren, wie sie tatsächlich kaufen – statt nach der Vertriebsgeografie, die üblicherweise die Account-Struktur bestimmt –, macht aus einer bloß interessanten Empfehlung eine handlungsrelevante Erkenntnis.
Diese Gruppen zu identifizieren, hat einen zweiten, weniger offensichtlichen Vorteil: Es zeigt auch, welche Kunden zu keiner dieser Gruppen gehören. Manche Accounts kaufen schlichtweg völlig anders als der Rest – aufgrund einer Legacy-Plattform, eines einzelnen dominanten Endprodukts oder einer Procurement-Policy, die sonst niemand teilt. Versucht man, diese Kunden krampfhaft der nächstbesten Gruppe zuzuordnen, erzeugt das nicht nur bei ihnen schlechte Empfehlungen, sondern verschlechtert schleichend auch die Empfehlungen für alle anderen Accounts dieser Gruppe. Sie draußen zu lassen, ist eine gezielte Entscheidung, kein Versäumnis.
Warum Exklusion genauso wichtig ist wie Detektion
Derselbe Instinkt – zu wissen, was man weglässt – muss noch eine Ebene tiefer greifen, denn die überzeugendsten Falschmuster basieren auf völlig realen Transaktionen. Angenommen, ein einzelner Kunde platziert eine sehr große Bestellung über eine ungewöhnlich breite Palette an Bauteilen. Rein am Volumen gemessen kann dieser eine Deal hunderte normale Aufträge überwiegen und wie eine starke, vielfach erprobte Kombination wirken. Das ist er jedoch keineswegs – er kam genau einmal vor, bei einem einzigen Account, aus Gründen, die nur für diesen Account galten. Bleibt das ungeprüft, wird es als vermeintlich sichere Empfehlung über ein gesamtes Segment hinweg ausgespielt. Relevanz ist hier jedoch die einzige Währung: Eine Empfehlung, die nicht zum vorliegenden Kunden passt, ist schlimmer als gar keine Empfehlung – denn sie kostet den Sales Rep Zeit und die Recommendation Engine ihre Glaubwürdigkeit. Der erste Sales Manager, der so etwas sieht, zieht sofort den folgerichtigen Schluss: Diese Engine versteht meinen Markt nicht.
Die Abhilfe ist weniger eine Technik als ein Grundprinzip: Evidenz zählt nach Breite, nicht nach Gewicht. Eine Kombination verdient den Status eines Musters erst dann, wenn sie sich unabhängig voneinander bei ausreichend vielen verschiedenen Kunden wiederholt, sodass Zufall als Erklärung ausscheidet. Kein einzelner Deal – egal wie groß – kann das allein begründen.
Diese Hürde gilt für das, was aus der Historie abgeleitet wird. Wissen, das als gezielte Intent-Vorgabe einfließt – wie ein Reference Design oder eine vom Produktmarketing definierte Cross-Sell Empfehlung –, muss diese Hürde nicht nehmen, da dies von vornherein kein statistischer Anspruch war. Es besitzt eine andere Form von Autorität und erreicht den Sales Rep entsprechend gekennzeichnet. Genau diese Unterscheidung ermöglicht es überhaupt erst, neu eingeführte Bauteile zu empfehlen, die nicht über eine Projekthistorie verfügen. Deshalb werden diese beiden Wissensarten sichtbar getrennt voneinander gehalten, anstatt sie in einem einzigen Score zu vermischen.
Dieselbe Zurückhaltung bestimmt auch, was überhaupt den Output erreicht: Bauteile, die kurz vor End-of-Life (EOL) stehen oder für bestimmte Märkte Restriktionen unterliegen, werden zurückgehalten, bevor ein Sales Rep sie empfohlen bekommt. Nichts davon ist spektakulär, und es wird selten diskutiert – aber die Kontrollen, die verhindern, dass Noise zum Signal erhoben wird, sind mindestens genauso viel wert wie die Detektion selbst.
Wo die Empfehlung landen muss
Glaubwürdigkeit hängt auch davon ab, wo die Empfehlung erscheint. Eine Rang-Liste in einem monatlichen Bericht überlässt dem Sales Rep die Übersetzungsarbeit; eine Empfehlung, die direkt an eine spezifische Opportunität gekoppelt und dem konkreten Projekt zugeordnet ist, nimmt ihm das ab. Diese Platzierung sorgt zudem dafür, dass sie live bleibt: Wird eine Opportunität initial unter der falschen Applikation eingeordnet – eine häufig erforderliche Korrektur während des Design-Ins –, ändern sich die Empfehlungen in dem Moment, in dem die Zuordnung korrigiert wird, da die Applikation Teil der Herleitung war. Der Output folgt dem aktuellen Status der Opportunität, nicht dem Status beim letzten Batch-Job-Lauf.
In diesem Setting erfüllt die Engine eine ganz spezifische Aufgabe: Sie identifiziert Lücken. Was fehlt auffällig – ausgehend von dem, was dieser Kunde in dieser Applikation mit diesem Profil bereits spezifiziert hat – im Vergleich zu vergleichbaren, erfolgreich abgeschlossenen Designs? FSE und FAEs tun dann das, was nur sie können: Sie wägen das ab gegen all das, was nicht in den Daten steht – die Roadmap des Kunden, die Platzierung eines Mitbewerbers, eine Qualifizierungshürde, ein Gespräch aus der Vorwoche. Das System schlägt vor, der Mensch entscheidet. Jeder Workflow, das diese Abfolge umkehrt, wird vom Vertrieb innerhalb kürzester Zeit umgangen.
Was der Mensch entscheidet, wird zur nächsten Antwort
Und weil der Mensch entscheidet, ist die Entscheidung selbst eine Information. Eine Empfehlung, die akzeptiert wird und zu einer neuen Design Registration führt, fließt als Evidenz in das Modell zurück: Regeln, die sich weiterhin bewähren, werden gestärkt; Regeln, die konsequent ignoriert werden, werden als solche sichtbar. Das ist der Unterschied zwischen einer Recommendation Engine und einer einmaligen Analyse: Qualität ist keine Ansichtssache mehr, sondern wird messbar und damit verbesserbar.
Der Effekt kumuliert zudem. Die jüngste State of Sales-Studie unter gut 4.000 Sales Professionals in 22 Ländern beziffert den Anteil der Arbeitszeit eines Reps, der tatsächlich mit Verkaufen verbracht wird, auf 40 %; der Rest entfällt auf Data Entry, Prospecting und interne Prozesse. Es gibt zwei Möglichkeiten, auf diese Zahl zu reagieren – und dieser Ansatz bedient beide. Ein großer Teil der verbleibenden 60 % besteht aus manueller Recherche: der Suche danach, was ein Kunde als Nächstes brauchen könnte, der Rekonstruktion dessen, was vergleichbare Accounts eindesigned haben, und dem manuellen Erstellen einer Shortlist. Arbeiten dieser Art müssen keineswegs von Menschen erledigt werden. Wird der Vertrieb davon entlastet, verschiebt sich die 40 % selbst – hin zu Kundengesprächen statt zu mehr Administration. Zudem erhöht sich der Ertrag der Stunden, die bereits mit Verkaufen verbracht wurden, da diese Gespräche nun auf dem Erfahrungsschatz der gesamten Organisation basieren – und nicht nur darauf, woran sich eine einzelne Person zufällig erinnert.
Die Daten sind bereits da und haben sich über Jahre angesammelt. Die Frage, die sich auf Management-Ebene stellt, ist nicht, ob sie kommerziell nutzbare Muster enthalten – das tun sie. Die Frage ist, ob irgendetwas im aktuellen Tech-Stack in der Lage ist, sie herauszuholen und der Person bereitzustellen, die die Kundenbeziehung hält – solange noch Zeit zum Handeln ist.
Die Portfolios, mit denen Vertriebsteams in der Elektronikbranche arbeiten, sind riesig und komplex – zehntausende oder hunderte Tausende bestellbarer Bauteile sind für einen Design-in Distributor oder Hersteller keine Seltenheit. Die offensichtliche Schlussfolgerung lässt nicht lange auf sich warten: Kein Sales Engineer, wie erfahren auch immer, kann einen Katalog dieser Größenordnung im Kopf behalten.
Das war jedoch nie das eigentliche Problem. Bauteile generieren Umsatz – aber selten einzeln. Ein Design erfordert mehr als nur die eine Komponente, nach der der Kunde zufällig gefragt hat. Und die Sockets, die Sie nicht besetzen, bleiben nicht leer; ein Mitbewerber besetzt sie. Der Umsatz, der ein erfolgreiches Design von einem mittelmäßigen Projekterfolg unterscheidet, liegt also in den Beziehungen zwischen den Bauteilen: Welche Komponente wird typischerweise zusammen mit welcher anderen verwendet, in welcher Art von Applikation und in welchem Kundenhintergrund? Diese Beziehungen sind das eigentliche Asset, und sie vervielfachen sich deutlich schneller als der Katalog selbst. Sie fehlen nicht – sie sind vergraben. Jede einzelne steckt bereits in den eigenen Unternehmensdaten, verteilt auf tausende abgeschlossener erfolgreicher Transaktionen, Design Registrations und Projekten. Doch nichts davon ist etwas wert, solange es nicht extrahiert und jemandem vorgelegt wird, der danach handeln kann. Genau diese Datenanalyse findet heute in den meisten Fällen nicht systematisch statt. Wer im CRM oder ERP Opportunität für Opportunität durchgeht, betrachtet stets nur den Einzelfall – während das Muster erst im Aggregat sichtbar wird. Und genau dieses Aggregat kann eine solche Einzelansicht nicht zeigen.
Nutzen, was die Systeme bereits enthalten
Diese zusammengefassten Muster nutzbar zu machen, ist keine Reporting-Aufgabe. Der Prozess muss kontinuierlich über den gesamten Datenbestand laufen und seine Erkenntnisse dem Vertrieb genau im richtigen Moment der Arbeit bereitstellen – dies ist exakt die Aufgabe einer Recommendation Engine. Eine speziell für diesen Anwendungsfall in der Elektronikindustrie entwickelte Recommendation Engine beginnt daher nicht mit neuen Daten, sondern mit den bereits vorhandenen Datensätzen. Sie ersetzt weder CRM noch ERP; sie setzt als Layer darauf auf und liest aus, was dort bereits vorhanden ist: Welche Kunden haben welche Bauteile gekauft, in welchen Projekten, für welche Applikationen und mit welchem Ergebnis? Es muss nichts Neues erhoben werden: Der Transactional Record, den Vertriebsteams seit Jahren pflegen – oft mit einer gewissen Enttäuschung darüber, wie wenig Nutzen sie dafür zurückerhalten –, enthält bereits alles darüber, was eindesigned wurde und was daraus geworden ist. Diese Historie erweist sich als das eigentliche wertvolle Rohmaterial.
Was diese Daten liefern, sind Muster: Kombinationen, die in erfolgreichen Designs immer wieder auftauchen. Und da die Engine als Intelligenz-Schicht und nicht als statischer Bericht fungiert, kann sie neben den vergrabenen Insights ein zweites Expertenwissen einbinden. Reference Designs enthalten bereits gezielte Engineering-Entscheidungen darüber, welche Komponenten zusammengehören. Das Produktmarketing weiß wiederum, welche Cross-Sell-Opportunitäten strategisches Gewicht haben – eine Einschätzung, die besonders bei Produkteinführungen (NPI - New Product Introductions) zählt, wo noch keine Transaktionshistorie vorliegt. Heute erreicht dieses Wissen meist nur wenige Personen in einer Schulung und verpufft danach häufig. Über denselben Layer ausgespielt, erreicht es jeden Sales Engineer – genau in dem Kontext, in dem es gebraucht wird: direkt an eine reale Opportunität angehängt, statt in einem Ordner zu liegen.
„Was verkauft sich zusammen?“ ist die falsche Frage
All das ist wertlos, wenn die an die Daten gestellte Frage zu generisch ist. Die naheliegende Frage – welche Produkte sich zusammen verkaufen – mittelt das Verhalten über eine Kundenbasis, die keineswegs einheitlich agiert, und liefert Empfehlungen, die zwar technisch korrekt, aber kommerziell weniger aussagefähig sind.
Die Frage muss mehr Kontext tragen: Nicht nur, welche Produkte zusammen auftreten, sondern in welcher Applikation und in welchem Kundenkontext. Eine Kombination, die bei Industrial Drives stark ist, kann in Automotive Body Electronics völlig irrelevant sein. Und ein Muster, das bei Tier-1-OEMs mit eigenen Design-Kapazitäten gilt, trifft möglicherweise nicht auf kleinere Design Houses zu, die stark auf Distributionssupport angewiesen sind. Kunden danach zu gruppieren, wie sie tatsächlich kaufen – statt nach der Vertriebsgeografie, die üblicherweise die Account-Struktur bestimmt –, macht aus einer bloß interessanten Empfehlung eine handlungsrelevante Erkenntnis.
Diese Gruppen zu identifizieren, hat einen zweiten, weniger offensichtlichen Vorteil: Es zeigt auch, welche Kunden zu keiner dieser Gruppen gehören. Manche Accounts kaufen schlichtweg völlig anders als der Rest – aufgrund einer Legacy-Plattform, eines einzelnen dominanten Endprodukts oder einer Procurement-Policy, die sonst niemand teilt. Versucht man, diese Kunden krampfhaft der nächstbesten Gruppe zuzuordnen, erzeugt das nicht nur bei ihnen schlechte Empfehlungen, sondern verschlechtert schleichend auch die Empfehlungen für alle anderen Accounts dieser Gruppe. Sie draußen zu lassen, ist eine gezielte Entscheidung, kein Versäumnis.
Warum Exklusion genauso wichtig ist wie Detektion
Derselbe Instinkt – zu wissen, was man weglässt – muss noch eine Ebene tiefer greifen, denn die überzeugendsten Falschmuster basieren auf völlig realen Transaktionen. Angenommen, ein einzelner Kunde platziert eine sehr große Bestellung über eine ungewöhnlich breite Palette an Bauteilen. Rein am Volumen gemessen kann dieser eine Deal hunderte normale Aufträge überwiegen und wie eine starke, vielfach erprobte Kombination wirken. Das ist er jedoch keineswegs – er kam genau einmal vor, bei einem einzigen Account, aus Gründen, die nur für diesen Account galten. Bleibt das ungeprüft, wird es als vermeintlich sichere Empfehlung über ein gesamtes Segment hinweg ausgespielt. Relevanz ist hier jedoch die einzige Währung: Eine Empfehlung, die nicht zum vorliegenden Kunden passt, ist schlimmer als gar keine Empfehlung – denn sie kostet den Sales Rep Zeit und die Recommendation Engine ihre Glaubwürdigkeit. Der erste Sales Manager, der so etwas sieht, zieht sofort den folgerichtigen Schluss: Diese Engine versteht meinen Markt nicht.
Die Abhilfe ist weniger eine Technik als ein Grundprinzip: Evidenz zählt nach Breite, nicht nach Gewicht. Eine Kombination verdient den Status eines Musters erst dann, wenn sie sich unabhängig voneinander bei ausreichend vielen verschiedenen Kunden wiederholt, sodass Zufall als Erklärung ausscheidet. Kein einzelner Deal – egal wie groß – kann das allein begründen.
Diese Hürde gilt für das, was aus der Historie abgeleitet wird. Wissen, das als gezielte Intent-Vorgabe einfließt – wie ein Reference Design oder eine vom Produktmarketing definierte Cross-Sell Empfehlung –, muss diese Hürde nicht nehmen, da dies von vornherein kein statistischer Anspruch war. Es besitzt eine andere Form von Autorität und erreicht den Sales Rep entsprechend gekennzeichnet. Genau diese Unterscheidung ermöglicht es überhaupt erst, neu eingeführte Bauteile zu empfehlen, die nicht über eine Projekthistorie verfügen. Deshalb werden diese beiden Wissensarten sichtbar getrennt voneinander gehalten, anstatt sie in einem einzigen Score zu vermischen.
Dieselbe Zurückhaltung bestimmt auch, was überhaupt den Output erreicht: Bauteile, die kurz vor End-of-Life (EOL) stehen oder für bestimmte Märkte Restriktionen unterliegen, werden zurückgehalten, bevor ein Sales Rep sie empfohlen bekommt. Nichts davon ist spektakulär, und es wird selten diskutiert – aber die Kontrollen, die verhindern, dass Noise zum Signal erhoben wird, sind mindestens genauso viel wert wie die Detektion selbst.
Wo die Empfehlung landen muss
Glaubwürdigkeit hängt auch davon ab, wo die Empfehlung erscheint. Eine Rang-Liste in einem monatlichen Bericht überlässt dem Sales Rep die Übersetzungsarbeit; eine Empfehlung, die direkt an eine spezifische Opportunität gekoppelt und dem konkreten Projekt zugeordnet ist, nimmt ihm das ab. Diese Platzierung sorgt zudem dafür, dass sie live bleibt: Wird eine Opportunität initial unter der falschen Applikation eingeordnet – eine häufig erforderliche Korrektur während des Design-Ins –, ändern sich die Empfehlungen in dem Moment, in dem die Zuordnung korrigiert wird, da die Applikation Teil der Herleitung war. Der Output folgt dem aktuellen Status der Opportunität, nicht dem Status beim letzten Batch-Job-Lauf.
In diesem Setting erfüllt die Engine eine ganz spezifische Aufgabe: Sie identifiziert Lücken. Was fehlt auffällig – ausgehend von dem, was dieser Kunde in dieser Applikation mit diesem Profil bereits spezifiziert hat – im Vergleich zu vergleichbaren, erfolgreich abgeschlossenen Designs? FSE und FAEs tun dann das, was nur sie können: Sie wägen das ab gegen all das, was nicht in den Daten steht – die Roadmap des Kunden, die Platzierung eines Mitbewerbers, eine Qualifizierungshürde, ein Gespräch aus der Vorwoche. Das System schlägt vor, der Mensch entscheidet. Jeder Workflow, das diese Abfolge umkehrt, wird vom Vertrieb innerhalb kürzester Zeit umgangen.
Was der Mensch entscheidet, wird zur nächsten Antwort
Und weil der Mensch entscheidet, ist die Entscheidung selbst eine Information. Eine Empfehlung, die akzeptiert wird und zu einer neuen Design Registration führt, fließt als Evidenz in das Modell zurück: Regeln, die sich weiterhin bewähren, werden gestärkt; Regeln, die konsequent ignoriert werden, werden als solche sichtbar. Das ist der Unterschied zwischen einer Recommendation Engine und einer einmaligen Analyse: Qualität ist keine Ansichtssache mehr, sondern wird messbar und damit verbesserbar.
Der Effekt kumuliert zudem. Die jüngste State of Sales-Studie unter gut 4.000 Sales Professionals in 22 Ländern beziffert den Anteil der Arbeitszeit eines Reps, der tatsächlich mit Verkaufen verbracht wird, auf 40 %; der Rest entfällt auf Data Entry, Prospecting und interne Prozesse. Es gibt zwei Möglichkeiten, auf diese Zahl zu reagieren – und dieser Ansatz bedient beide. Ein großer Teil der verbleibenden 60 % besteht aus manueller Recherche: der Suche danach, was ein Kunde als Nächstes brauchen könnte, der Rekonstruktion dessen, was vergleichbare Accounts eindesigned haben, und dem manuellen Erstellen einer Shortlist. Arbeiten dieser Art müssen keineswegs von Menschen erledigt werden. Wird der Vertrieb davon entlastet, verschiebt sich die 40 % selbst – hin zu Kundengesprächen statt zu mehr Administration. Zudem erhöht sich der Ertrag der Stunden, die bereits mit Verkaufen verbracht wurden, da diese Gespräche nun auf dem Erfahrungsschatz der gesamten Organisation basieren – und nicht nur darauf, woran sich eine einzelne Person zufällig erinnert.
Die Daten sind bereits da und haben sich über Jahre angesammelt. Die Frage, die sich auf Management-Ebene stellt, ist nicht, ob sie kommerziell nutzbare Muster enthalten – das tun sie. Die Frage ist, ob irgendetwas im aktuellen Tech-Stack in der Lage ist, sie herauszuholen und der Person bereitzustellen, die die Kundenbeziehung hält – solange noch Zeit zum Handeln ist.
Inhalt
Inhalt

Antonello Terlizzi leitet bei FASTND die Datenstrategie und -integration und verantwortet die Recommendation-Engine im Kern der Plattform. Er verbindet einen Ingenieurshintergrund mit einem MBA und hat in den letzten Jahren datengetriebene Vertriebs- und Marketing-Tools für die Halbleiterindustrie entwickelt. In seinen Beiträgen schreibt er darüber, wie aus Daten belastbare Vertriebsentscheidungen werden.
Antonello Terlizzi leitet bei FASTND die Datenstrategie und -integration und verantwortet die Recommendation-Engine im Kern der Plattform. Er verbindet einen Ingenieurshintergrund mit einem MBA und hat in den letzten Jahren datengetriebene Vertriebs- und Marketing-Tools für die Halbleiterindustrie entwickelt. In seinen Beiträgen schreibt er darüber, wie aus Daten belastbare Vertriebsentscheidungen werden.
Erleben Sie selbst, wie FASTND Ihren Vertrieb unterstützt
© 2026 FASTND GmbH.
© 2026 FASTND GmbH.
© 2026 FASTND GmbH. Alle Rechte vorbehalten.